边听边说
每一秒,Duopra 都在决定这一秒是听还是说。你说完它接话,你句中停顿它不抢,你插话它就让。
它边听边说,还会自己判断什么时候该动手。
其实是 150 欧元,不是 100。Duopra 听到改口,自己决定调用工具,并在还在说话时就把调用发了出去。
全双工模型已经知道什么时候听、什么时候说。Duopra 还知道什么时候动手——它在话说到一半时自己调用工具,这些动作从不出声。
每一秒,Duopra 都在决定这一秒是听还是说。你说完它接话,你句中停顿它不抢,你插话它就让。
工具调用走一条私有通道,在 Duopra 还在说话时就发出。调用本身从不被念出来,念出来的只有结果。
请求说到一半改了数值,进入工具的只有最后那个值——被放弃的 100 不会。
一口气说出的两项修改,变成两次调用;每一项都等结果返回之后才念出。
接上一个后台模型,它就成了又一个工具 query(task)。Duopra 把事情交给后台,和调用任何工具一样:对话不停,也听不到任何交接。
一个工具就是一份 JSON schema:名字、描述和参数,在运行时提供。写下你自己的工具——日程、数据库、家里的设备——Duopra 就能调用它。
两段评测中的会话,按录音时间重放。
每一秒,Duopra 读入新的音频和已返回的工具结果,同时输出三样东西。
这是一个因果策略,条件是到目前为止的音频、已注入的观测和它自己之前的输出。对话与工具调用一起决定,不在组件之间来回传递。
后台 agent 以 query(task) 的形式出现,参数是对用户任务的完整描述。直接调用还是委派,是同一个策略做出的同一类决定——没有外部调度器。
运行时异步执行每次调用,并在结果返回后的第一个 1 秒边界注入上下文。等待期间模型照常听、照常说,结果到了才报出数值。
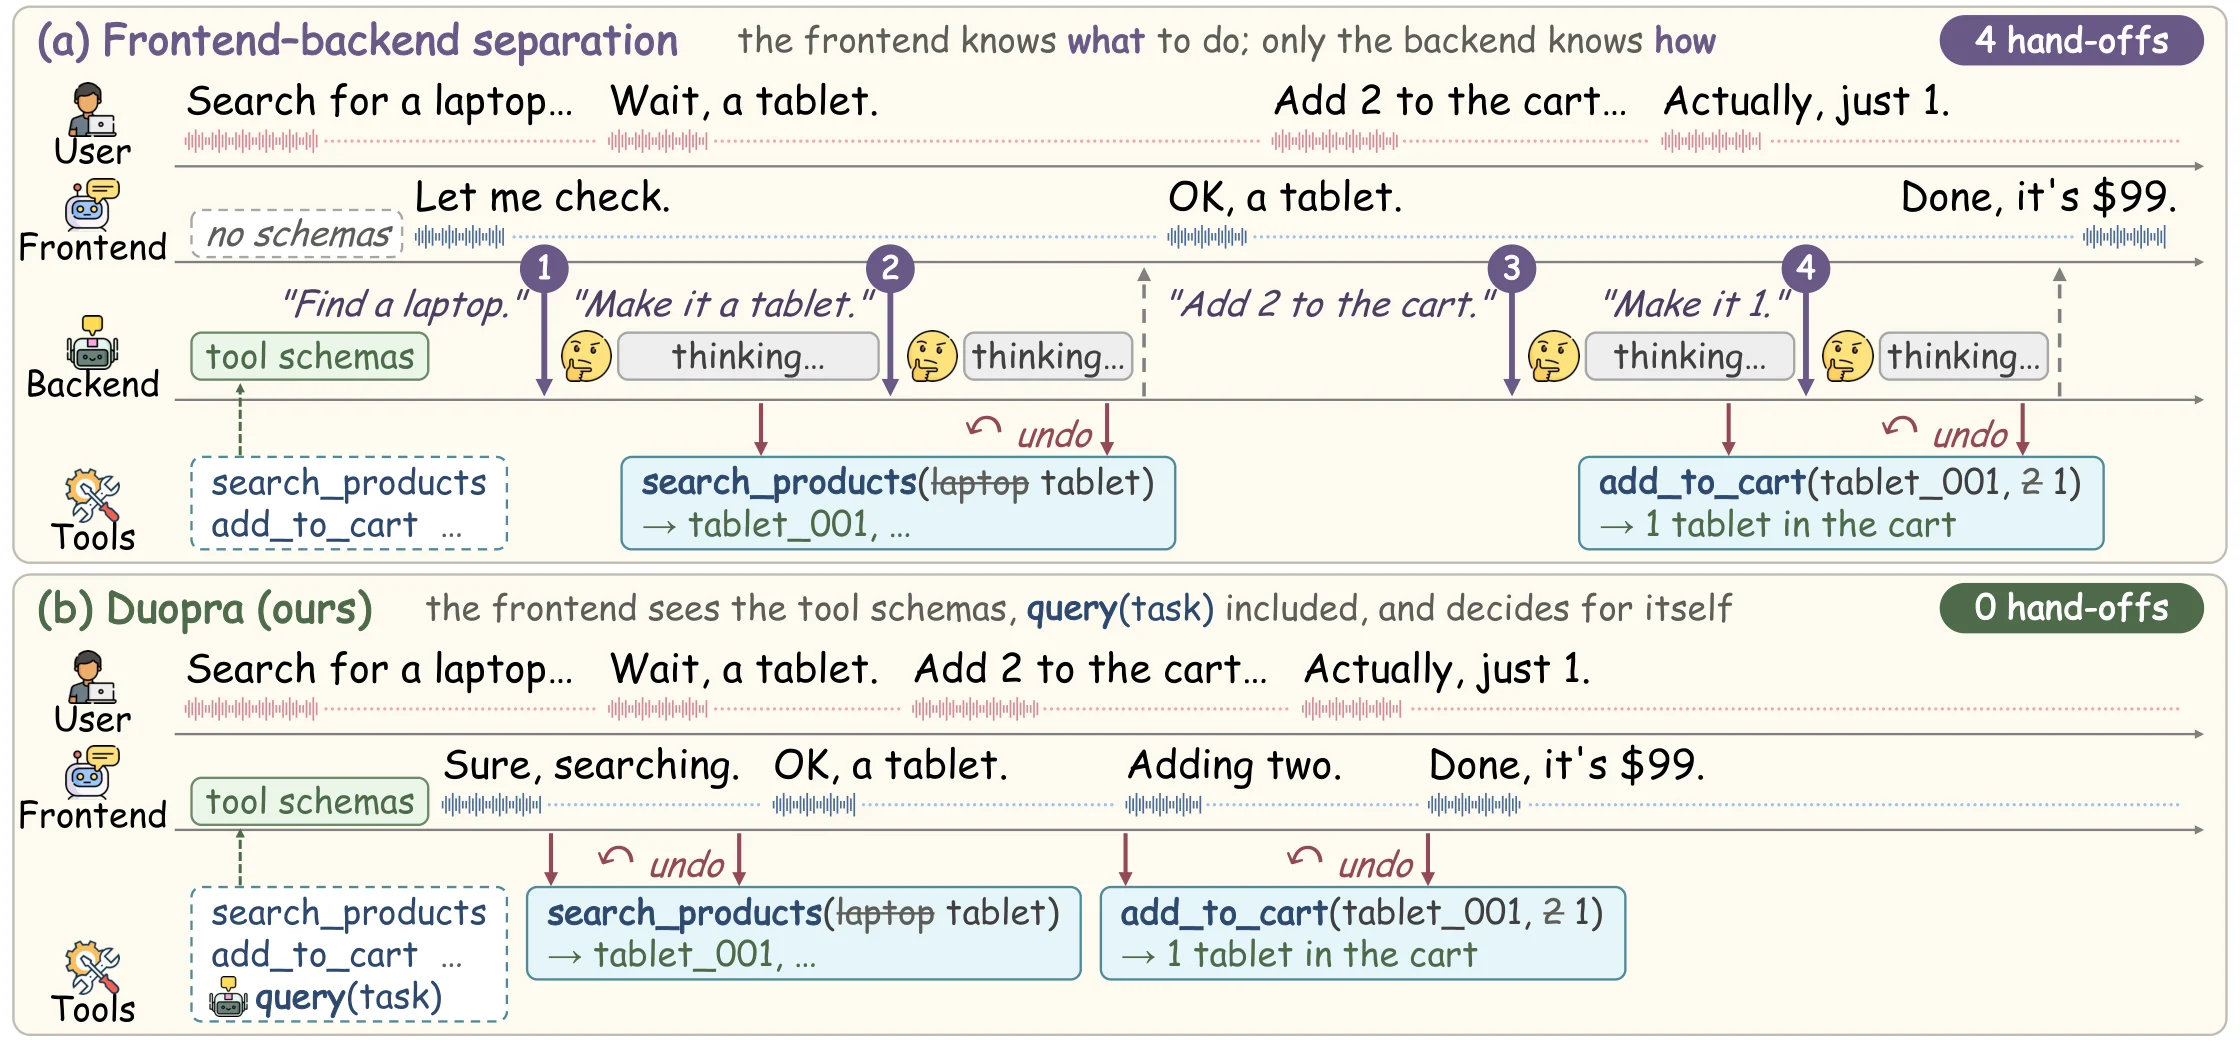
ecommerce_19;示意图)。用户既改了商品(从笔记本电脑改成平板),也改了数量(从两件改成一件);add_to_cart 依赖 search_products 返回的商品 ID。(a) 领域工具的 schema 只在后台时,前台可能要连续多次交接,才能把不断变化的请求转达过去,改口和工具之间的依赖也就更难保住。(b) schema 可见时,Duopra 可以不经交接、直接发出改正后的领域工具调用,同时 query(task) 依然可用。划掉的值和弧形箭头表示被取代的请求。论文表 18(a) 记录了这条请求一次实际的委派成功。每个阶段解决一个问题:动作的格式、要不要动手,以及 thinker 一变就会跑偏的声音。
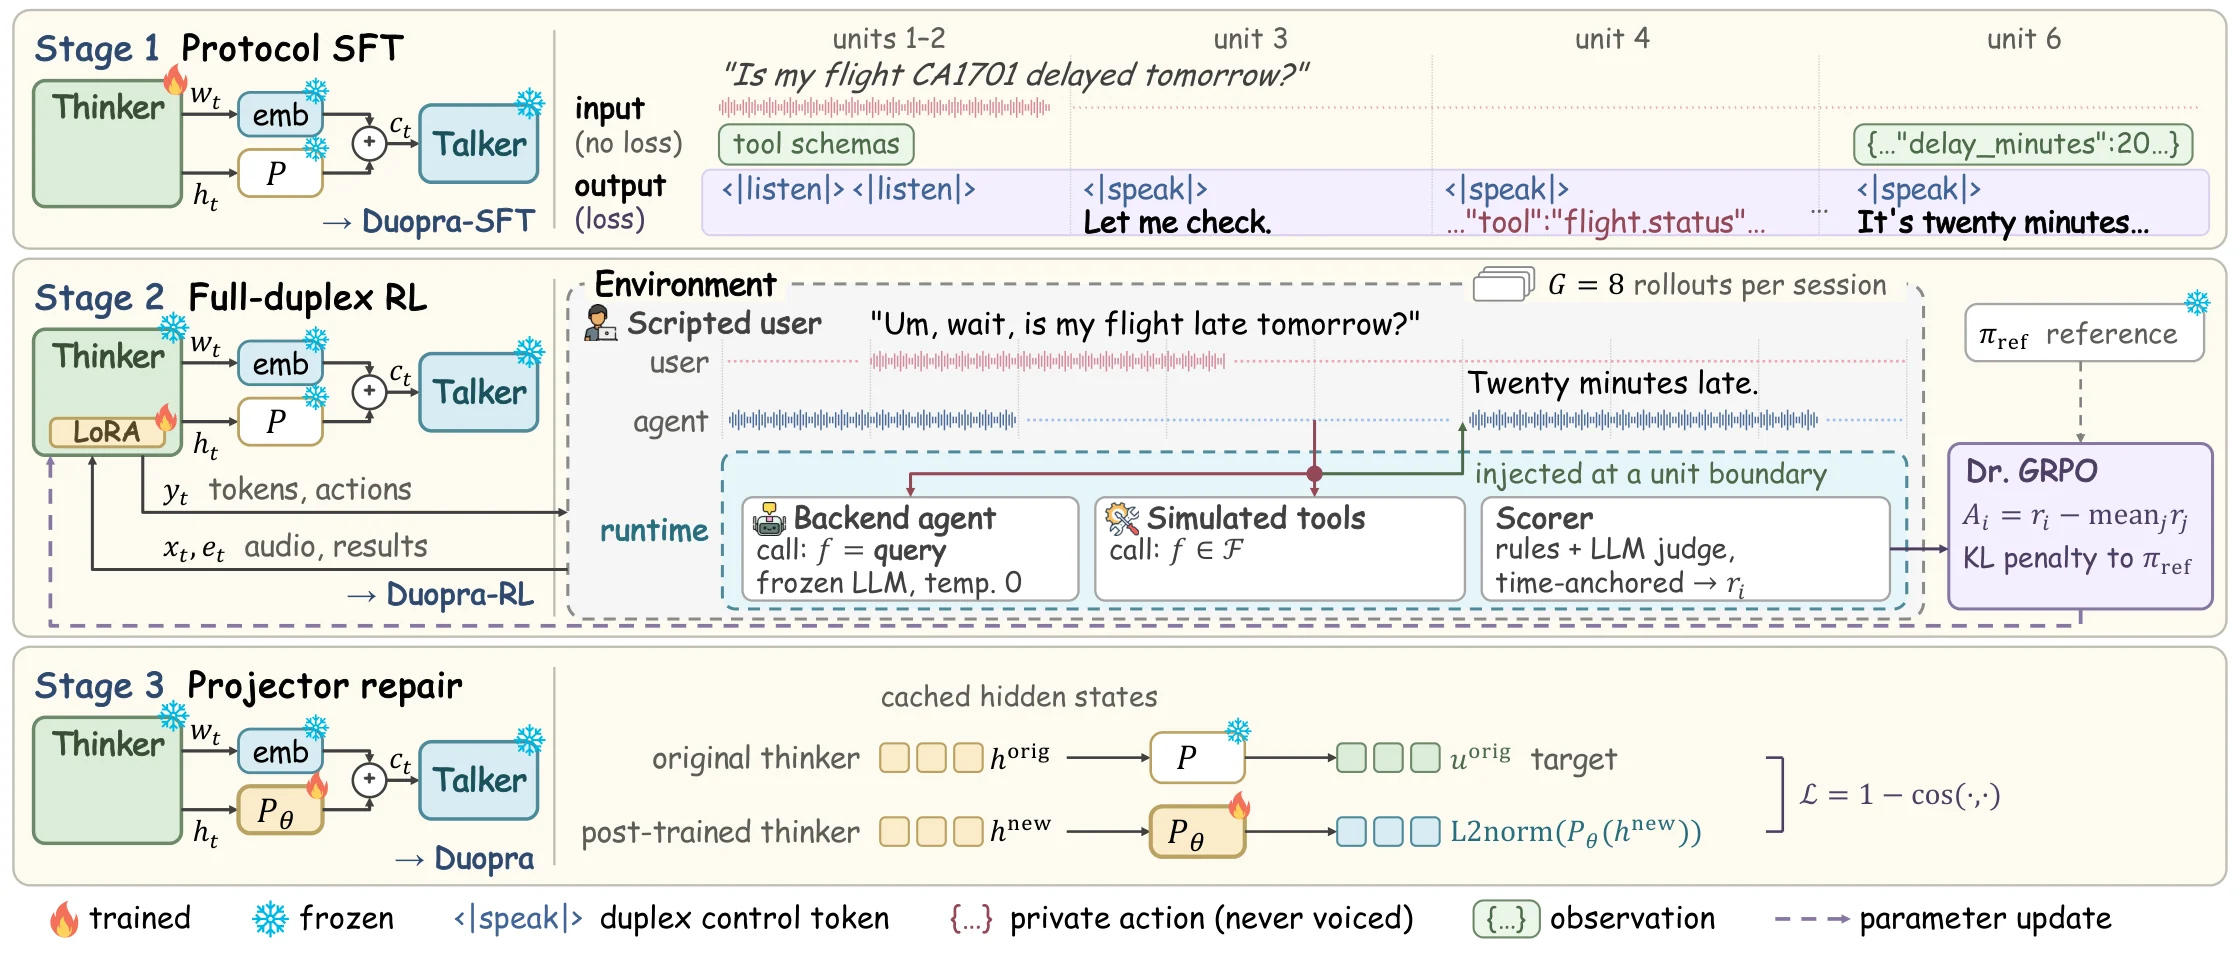
学会动作的格式。
在合成会话上对 thinker 做监督微调,示范完整的协议:按 schema 调用工具,结果返回前不播报,只追问缺失的值。
学会何时动手。
在 thinker 的 LoRA 上做 Dr. GRPO,每个任务 8 个 rollout;沙盒给每个 rollout 播放同一个脚本化用户。时间锚定的截止与结果分级,奖励及时、完整、有依据的调用。
让声音保持清晰。
后训练会改变 thinker 的隐藏状态,而这些状态决定 talker 怎么发音。只在缓存特征上重训两者之间的 projector;文字、控制 token 和调用都不受影响。
Full-Duplex-Bench v3 上的 Pass@1:接后台时 49.3%,自己调用工具时 47.7%。
一次会话里实际执行的调用与金标完全一致——工具正确、参数全对、没有多余调用——才算通过。
Full-Duplex-Bench v3:100 条真实、不流利的英文录音,12 个模拟 API。Duopra 由我们的评测流程跑出——3 个种子,每种配置 300 个会话,judge 为 Qwen3.8-27B;± 为种子间的标准差。斜线条为已发表的结果,用的是各自来源的评测流程和 judge(多为 GPT-4o),仅作参照,并非同一协议下的排名。* 为商业系统。
300 个会话各自的结局,Duopra 各阶段均为自己调用工具。
多步请求变得可解:在需要两到三次调用的 102 个会话里,Duopra 通过 28 个,SFT 之后只有 2 个。剩下的提升空间在参数上——参数错误(占全部会话 19.3%)已经和没有调用(18.7%)一样多。
| 运行(300 个会话) | 通过 | 参数错误 | 漏调用 | 多调用 | 没有调用 |
|---|---|---|---|---|---|
| Duopra-SFT | 78 | 17 | 38 | 1 | 166 |
| Duopra-RL1 | 80 | 17 | 72 | 0 | 131 |
| Duopra | 143 | 58 | 40 | 3 | 56 |
FDB v1.0 接管率:Duopra 与它所基于的模型 Realtime-Venus-Audio,在同一流程下测得(%)。
| 系统 | 工具 | 参数 | 回复 | Pass@1 |
|---|---|---|---|---|
| 商业系统*,文献报告值 | ||||
| GPT-Realtime | 87.6 | 68.0 | 79.2 | 60.0 |
| Gemini Live 3.1 | 81.7 | 58.8 | 71.8 | 54.0 |
| MOSS-Live | n/a | n/a | n/a | 51.0 |
| Gemini Live 2.5 | 78.6 | 59.3 | 55.4 | 49.0 |
| Cascaded | 80.3 | 56.2 | 60.0 | 45.0 |
| Grok | 79.7 | 54.2 | 61.7 | 43.0 |
| Ultravox v0.7 | 79.4 | 51.3 | 51.0 | 41.0 |
| 开源系统,文献报告值 | ||||
| Hu et al.,Qwen3-235B 后台 | 71.7 | 55.2 | 67.0 | 48.0 |
| DuplexAgent-RSI | 97.4 | 57.0 | n/a | 47.0 |
| Realtime-Venus-Audio,离线 | 82.0 | 52.2 | n/a | 42.0 |
| Gander,GPT-5.6 | 75.9 | 50.3 | 49.0 | 40.0 |
| NemotronLabs VoiceChat | 82.5 | 42.2 | n/a | 33.0 |
| Duopra,我们的评测流程 | ||||
| Duopra,自己调用工具 | 76.7 | 56.2 | 66.3 | 47.7 ± 3.5 |
| Duopra,Qwen3-8B 后台 | 81.8 | 57.0 | 70.6 | 44.7 ± 5.7 |
| Duopra,DeepSeek 后台 | 71.8 | 55.0 | 69.0 | 49.3 ± 3.5 |
工具:工具名 F1,不需要 judge(Hu et al. 报告的是工具选择准确率)。参数:参数准确率。回复:回复质量。n/a:未报告。加粗:各组内最好。已发表的结果来自各自来源的评测流程和 judge(多为 GPT-4o),仅作参照,并非同一协议下的排名;Duopra 的结果用 Qwen3.8-27B 作 judge。DuplexAgent-RSI 基于 VoiceChat(在 Qwen-Realtime 上为 49.0),参数按字符串精确匹配;Realtime-Venus-Audio 离线评测时工具定义写在提示词里;MOSS-Live 报告的是工具调用成功率。“自己调用工具”即论文中的 Direct 设置;标出后台模型的为 Backend 设置,此时只看得到 query(task)。我们在自己的评测流程中运行的其他开源系统,列在论文的表 2 和表 11 中。
| 指标 | 数值 |
|---|---|
| 用户说完后接话 ↑ FDB v1.0 | 75.6 |
| 用户句中停顿时抢话 ↓ FDB v1.0 | 5.4 |
| 被打断后作出回应 ↑ FDB v1.0 | 91.3 |
| 接话率 ↑ FDB v3,自己调用工具 | 93.0 |
| VoiceBench 九类均值 ↑ | 55.9 |
| 给出事实答案的延迟 ↓ 领域工具与后台同时可见,Qwen3-8B | 10.42 s |
Pass@1 只看调用记录,不看语音转写。± 为 3 个种子的标准差。涉及判分的指标由 Qwen3.8-27B 作 judge;工具名 F1 不需要 judge。给出事实答案的延迟测到说出事实答案为止,包含运行时和工具执行的时间。
全双工交互模型已展现出很强的对话能力(conversational agency),能够自然、低延迟地完成话轮转换、附和与打断。然而,要成功完成任务,还需要任务能力(task agency):及时调用工具,并在用户改口后修正参数。前后台智能体把发起与执行分开:前台决定是否发出请求、请求什么,后台决定怎么做。执行可以交给后台,但没发出的请求无从执行,不完整的请求还可能把后台引错方向。我们在 FD-Bench-v3 上研究这一问题:在我们的流式设置中,Realtime-Venus-Audio + Harness 的多数失败发生在任何领域工具执行之前。
我们提出 Duopra:一个在学习对话控制的同时学习执行任务的全双工交互模型。Duopra 把后台当作一个工具,它接收一条自包含的自然语言请求。直接调用与后台委派共用同一个动作接口,也面对同样的要求:忠实地发起、正确地执行。它的三阶段训练包括:协议 SFT;奖励及时、完整执行的全双工强化学习;thinker 更新后只训练 projector,修复 talker 的条件输入。后台固定时,Pass@1 从 4.7% 升至 44.7%;Duopra 在 Direct 设置下达到 47.7%(SFT 后为 26.0%),在接 DeepSeek 的 Backend 设置下达到 49.3%。相比基座模型,它在三项 FDB v1.0 接管率上都有提升。这些结果表明,任务能力可以与关键的对话能力并存。
@misc{duopra2026,
  title  = {Duopra: From Full-Duplex Conversation
            to Full-Duplex Agency},
  author = {Chen, Chiyu and Cheng, Pengzhou and Ma, Yuezhao and Li, Xiaocheng
            and Liu, Can and Hu, Haonan and Yao, Yao and Yang, Yifei
            and Lu, Yijie and Wang, Taolei and Li, Yansi and Wu, Muhuan
            and Zhang, Zhuosheng and Liu, Gongshen and Sun, Chenglu},
  year   = {2026},
  note   = {Preprint forthcoming},
  url    = {https://cychen2003.github.io/duopra/}
}
预印本公开后,这条记录会补上链接。